IA local en casa: qué equipo mueve de verdad un LLM
Elige equipo para IA local: pesos, KV cache, contexto y memoria. Incluye un cálculo reproducible y explica qué falta para comparar rendimiento.
En esta guía10 secciones
Me pasó un domingo por la tarde. Estaba pidiéndole a un chatbot de la nube que me reescribiera un script y, a la cuarta iteración, me saltó el cartelito: has alcanzado tu límite, vuelve dentro de tres horas. Un script mío, en un problema mío, y resulta que el ritmo lo marcaba el contador de otro. Esa misma semana otro modelo se negó a explicarme cómo funcionaba una técnica de escaneo de red de lo más normal “por seguridad”. Ahí decidí bajarme la IA a casa, al mismo laboratorio donde ya corre todo lo demás.
Y la sorpresa fue doble: primero, que un modelo abierto en local hoy da para muchísimo más de lo que pensaba. Y segundo, que casi todo lo que se lee sobre “qué equipo necesitas” está mal enfocado. Voy a contarte las dos cosas, con la parte de hardware sin optimismo de folleto.
[aff]Hay enlaces de afiliado más abajo: si compras algo desde ellos me llevo una pequeña comisión y a ti no te cuesta ni un céntimo más. En calidad de Afiliado de Amazon, obtengo ingresos por las compras adscritas que cumplen los requisitos aplicables.
¿El modelo cabe pero se dispara la memoria al alargar el chat? Ve al ejemplo de KV cache y contexto.
Ampliación 9 oct 2026: cálculo de caché verificado y límites del ancho de banda aclarados. No es una prueba de velocidad de estos equipos.
Por qué querrías la IA en tu propia máquina
No es postureo de homelab. Son cuatro razones concretas, y las he vivido las cuatro.
Las cuotas. En la nube pagas por token o por mes, y en cualquiera de los dos casos hay un techo. Cuando le coges el gusto a usar un modelo para todo —resumir, programar, ordenar notas— ese techo llega antes de lo que crees. En local no hay contador: el único límite es cuánto aguanta tu máquina despierta, y la electricidad de un mini PC es ridícula.
La censura y los filtros. Los modelos de la nube vienen con una capa de “esto no te lo cuento” que muchas veces se pasa de frenada. Para trabajo técnico legítimo —seguridad, ingeniería inversa, temas médicos o legales— es un incordio real. Un modelo abierto en tu equipo responde a lo que le preguntas sin llamar a un comité.
El coste a la larga. Una suscripción son cientos de euros al año, para siempre. Un equipo capaz de mover IA local es un pago único que además te sirve para el resto del laboratorio. Si le vas a dar uso, los números terminan cuadrando.
La privacidad, que para mí es la gorda. Todo lo que escribes en un chat de la nube viaja a un servidor ajeno y, según la letra pequeña, puede acabar entrenando al siguiente modelo. Tus correos, tu código, tus ideas a medio cocer. En local no sale ni una frase de tu red. Es la misma razón por la que monto mis servicios en casa en vez de alquilarlos: si el dato es mío, se queda conmigo.
¿Están los modelos abiertos a la altura?
Esta es la pregunta honesta, y la respuesta honesta es “para lo tuyo, casi seguro que sí”.
Los modelos abiertos de la última hornada —Llama 3.3, Qwen, DeepSeek, Gemma, la familia gpt-oss— han cerrado buena parte de la distancia con los de pago para el trabajo del día a día. Redactar, resumir un texto largo, traducir, programar, ordenar ideas, responder sobre documentos tuyos: en todo eso un buen modelo de 14B a 70B cumple de sobra, y encima lo hace sin enviar nada fuera.
Donde la nube todavía saca ventaja es en el filo: razonamiento muy complejo, matemáticas duras, cadenas de pasos largas donde un modelo enorme aún se equivoca menos. Si tu trabajo vive ahí, ten los dos y tira del de la nube para esos casos. Pero para el 90% de lo que la gente le pide de verdad a una IA, un modelo local bien elegido no te va a dejar tirado. He trasteado unos cuantos de estos abiertos en equipos de gama alta y la sensación es esa: ya no es un juguete, es una herramienta.
Lo que no te voy a hacer es enseñarte una gráfica de MMLU con números que cambian cada mes y que la mitad de las webs se inventan. La comparación que sí importa para decidir hardware no es la de calidad, es la de velocidad. Y ahí viene lo interesante.
Ancho de banda: una pista, no un benchmark
Durante la generación de una respuesta, leer los pesos de un modelo denso puede limitar la velocidad. Dividir el ancho de banda entre los bytes de los pesos da una aproximación idealizada para una secuencia. No predice por sí sola los tokens por segundo. Ignora cómputo, tráfico de la caché, transferencias y cómo el motor aprovecha el equipo. Un token tampoco equivale siempre a una palabra.
Procesar el texto de entrada (prefill) y generar los siguientes tokens (decode) son trabajos distintos. La cuenta anterior no sirve para intercambiar sus resultados. Tampoco describe igual un modelo denso y uno de expertos (MoE), ni una conversación y varias peticiones agrupadas.
KV cache: por qué un modelo que cabe puede quedarse sin memoria
Los pesos no son toda la cuenta. La KV cache guarda claves y valores de los tokens anteriores para reutilizarlos durante la generación. En atención completa, un contexto mayor aumenta esa caché y el trabajo de atender a esos tokens. La memoria unificada no lo elimina: ofrece una forma de compartir memoria, no contexto ilimitado.
Una pregunta pendiente de un lector en Mastodon señalaba precisamente esto: ¿a qué longitud de contexto deja de bastar la ventaja del ancho de banda? Esta guía no aporta un cruce medido entre equipos. Para ponerle una cifra haría falta comparar el mismo modelo, motor, precisión y carga. Lo que sí podemos calcular es el espacio de la caché bajo supuestos explícitos.
Una cuenta que puedes repetir sin descargar un modelo
Para atención completa, capas iguales y claves/valores del mismo tamaño, sin cuantización ni caché compartida entre solicitudes:
bytes KV = 2 × capas × cabezas KV × dimensión de cabeza
           × tokens guardados × bytes por elemento × secuencias
El 2 cuenta claves y valores. Usa las cabezas KV, no automáticamente las cabezas de consulta: con GQA pueden ser distintas. La documentación de Hugging Face explica las dimensiones de estos tensores. El resultado no incluye pesos, sistema operativo, buffers del motor ni sobrecostes de asignación.
Este ejemplo es sintético: 32 capas, 8 cabezas KV, dimensión 128 y FP16 (2 bytes por elemento). No representa la ficha ni el consumo medido de un modelo comercial.
| Tokens guardados por secuencia | KV de una secuencia | KV de dos secuencias independientes |
|---|---|---|
| 4.096 | 0,50 GiB | 1,00 GiB |
| 8.192 | 1,00 GiB | 2,00 GiB |
| 32.768 | 4,00 GiB | 8,00 GiB |
Descarga el ejemplo de cálculo en Python y ejecútalo con python3 kv-cache-ejemplo.py. Sólo hace operaciones aritméticas: no instala dependencias, conecta a la red ni carga un LLM. Su salida, comprobada el 9 de octubre de 2026, es:
Tokens  Secuencias  KV (GiB)
  4096           1      0.50
  4096           2      1.00
  8192           1      1.00
  8192           2      2.00
 32768           1      4.00
 32768           2      8.00
Q4 en el nombre de los pesos no significa KV a 4 bits. Son decisiones diferentes. Ollama documenta tipos de caché y sus compromisos de precisión en su FAQ. También explica que el contexto y las solicitudes paralelas aumentan la memoria necesaria. Antes de tocar ajustes globales, comprueba el modelo y la versión que usas; un ahorro de memoria no garantiza la misma calidad de respuesta.
La fórmula tampoco cubre todas las arquitecturas. Con ventana deslizante, algunas capas dejan de crecer al alcanzar su ventana; una caché estática puede reservar más de lo ocupado. Los motores con prefijos compartidos o caché cuantizada requieren otra contabilidad. La guía de estrategias de caché distingue estos casos. GiB aquí son potencias de 1024, no GB decimales.
Qué pedirle a una prueba antes de comprar
Para investigar ese cruce, mantén iguales los pesos y su cuantización, la precisión KV, versión del motor, backend y número de solicitudes. Compara varias longitudes de entrada y registra por separado tiempo de procesamiento, velocidad de generación y memoria. Anota si hay descarga parcial a CPU o intercambio a disco: cambia la comparación.
llama-bench distingue pruebas de procesamiento (pp) y generación (tg), y su opción de profundidad -d permite precargar contexto. La documentación de llama.cpp detalla esas opciones; sus mediciones no incluyen tokenización ni muestreo. Es una vía para diseñar la prueba, no un benchmark ejecutado en esta guía.
Para elegir equipo, empieza por el modelo y el contexto que necesitas. Después comprueba si caben pesos, caché y el resto de la carga. Sólo entonces compara rendimiento medido en condiciones equivalentes: más GB/s no asegura por sí solo que una máquina gane con cualquier contexto.
Instalarlo es más fácil de lo que crees
La parte técnica da menos miedo del que parece. La vía más cómoda hoy es Ollama: un programa que se encarga de descargar el modelo, cuantizarlo, detectar tu gráfica y darte un chat en la terminal y una API local, todo en uno.
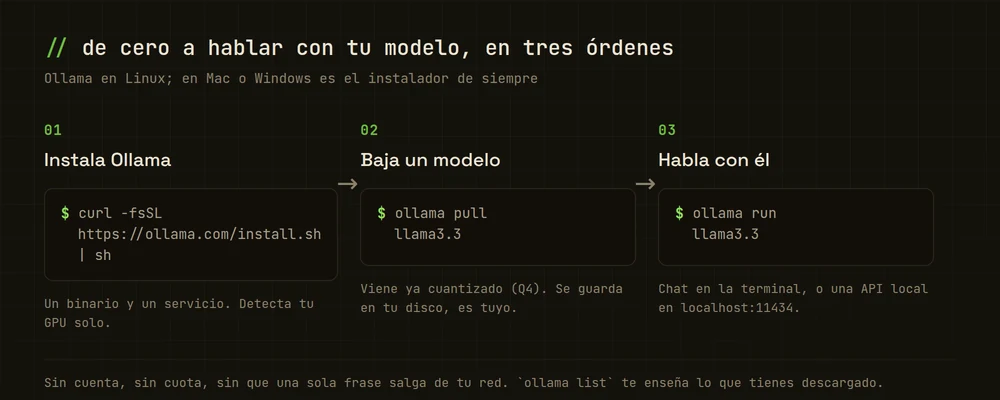
En un Linux, esto es literalmente todo:
# 1. Instalar Ollama (deja un servicio corriendo en segundo plano)
curl -fsSL https://ollama.com/install.sh | sh

# 2. Bajar un modelo (viene ya cuantizado en Q4, listo para tu RAM)
ollama pull llama3.3

# 3. Hablar con él
ollama run llama3.3
A partir de ahí tienes una API en localhost:11434 con la que puedes conectar tu editor, un script o una interfaz web tipo Open WebUI si quieres algo más de salón. ollama list te enseña lo que tienes descargado. Ni cuenta, ni cuota, ni una sola frase saliendo de tu red.
Qué modelo mueve de verdad cada equipo
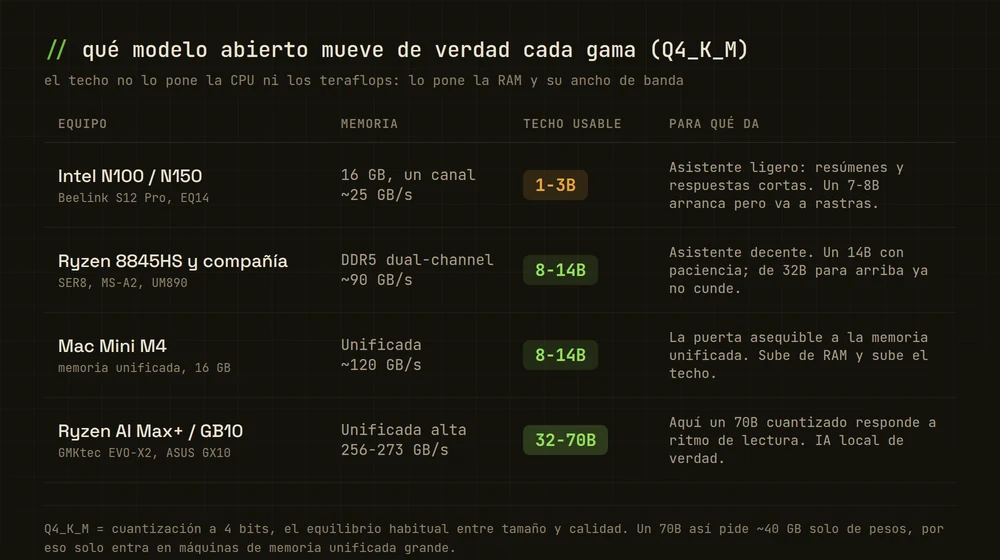
Estas gamas sirven como orientación inicial para pesos en Q4, no como garantía de velocidad. La configuración de RAM, el contexto y el motor pueden cambiar qué modelo resulta utilizable:
Traducido a decisiones:
- Un Intel N100 o N150 (memoria de un solo canal) se queda en un asistente ligero de 1-3B: resúmenes, respuestas cortas, clasificar texto. Un 7-8B arranca, pero va tan lento que se te quitan las ganas. Como primer contacto para ver si esto te sirve, cumple; como máquina de IA, no es lo suyo.
- Un Ryzen (o Intel) con DDR5 dual-channel sí te da un asistente local honesto de 8B a 14B. Suficiente para redactar, resumir y programar cosas normales, y además te vale de todoterreno para el resto del homelab. Es, probablemente, donde deberías empezar en serio.
- Para 32B o más, pide una prueba con tu carga. Que el modelo quepa en RAM no dice cuánto tardará en responder ni qué contexto podrás mantener.
- Para 70B, compara capacidad y rendimiento por separado. Una máquina con mucha memoria unificada puede alojar los pesos y la caché, pero también hay soluciones con GPU dedicada. El ritmo depende de la configuración y del software.
Puedes filtrar los equipos justo por esto en el comparador de mini PC —tiene una columna de IA local con el tamaño que cada uno mueve con soltura y el porqué—, ver de un vistazo cuál elegir para IA local y la gama completa en la comparativa a fondo.
Los equipos que recomiendo
Ordenados por lo que quieres hacer, no por precio a secas.
Para empezar y quitarte el gusanillo
Beelink SER8 — Ryzen 7 8845HS
Ocho núcleos para cargas que necesiten más CPU que un equipo de entrada. La oferta de referencia incluye 24 GB y SSD de 1 TB; decide la RAM necesaria antes de planificar máquinas virtuales.
- +8 núcleos / 16 hilos Zen 4, Radeon 780M
- +Dos ranuras NVMe
- +Memoria DDR5 ampliable: confirma módulos y capacidad compatibles
- -Compara el precio con otras configuraciones completas
- -Un solo puerto Ethernet: para doble red, considera otro modelo
≈ 819 €
27 sep 2026 · 24 GB RAM · SSD 1 TB · 8845HS · Amazon
Un Ryzen 7 con DDR5 mueve un 8B fluido y un 14B con algo de paciencia, y además te vale de todoterreno para el resto del homelab: Docker, Plex, alguna máquina virtual. Es el punto dulce si quieres probar IA local sin comprar una máquina solo para eso. No esperes 70B, pero para el asistente del día a día cumple.
La puerta asequible a la memoria unificada
Apple Mac Mini M4 — 16 GB, memoria unificada
La forma más barata de tocar memoria unificada para IA local. Con 16 GB mueve modelos de 8B a 14B con soltura y en silencio; el ecosistema de IA en macOS está muy pulido. No es un equipo de 70B, pero para empezar bien y consumir poco es difícil de batir.
- +Memoria unificada (~120 GB/s): más ancho de banda que un mini PC x86 corriente
- +Silencioso de verdad y consumo mínimo en idle
- +macOS con ecosistema de IA local muy accesible
- -16 GB de base: techo en 8-14B; para 32B/70B toca un M4 Pro con más RAM (otro precio)
- -16 GB en referencia; hasta 32 GB configurables al comprar, sin ampliación posterior
930–970 €
Referencia histórica
El Mac Mini M4 es, para su precio, la forma más barata de tocar memoria unificada. Con 16 GB te mueve modelos de 8B a 14B con soltura y en silencio absoluto, y si subes de configuración sube el techo. No es la bestia de 70B, pero macOS y su ecosistema de IA local están muy pulidos y el consumo es de risa. Si ya vives en Apple, es la opción obvia, aunque conviene saber dónde se atraganta antes de dejarlo fijo de servidor: Docker y los servicios de siempre tienen sus matices en macOS, y lo desmenuzo en la review del Mac Mini M4 como servidor casero. Si en cambio quieres el techo de 70B en x86, mira el duelo GMKtec EVO-X2 vs Mac Mini M4.
IA local de verdad: 70B en casa
GMKtec EVO-X2 — Ryzen AI Max+ 395, hasta 128 GB
La caja pensada para correr modelos grandes en local: APU Ryzen AI Max+ 395 con memoria unificada LPDDR5X a ~256 GB/s. Es donde un 70B cuantizado deja de ser una promesa y responde a ritmo de lectura.
- +Memoria unificada LPDDR5X-8000 (~256 GB/s): 32B de sobra y 70B Q4 usable
- +16 núcleos Zen 5 y Radeon 8060S: también virtualiza y juega fuerte
- +Hasta 128 GB para cargar el modelo entero sin salir a disco
- -Precio y consumo de otra liga; no es un mini de 24/7 barato
- -Para solo multimedia y contenedores es tirar dinero: su gracia es la IA
≈ 3.999,96 €
27 sep 2026 · 128 GB RAM · SSD 2 TB · Amazon
Aquí es donde la cosa se pone seria. El GMKtec EVO-X2 lleva el Ryzen AI Max+ 395 con memoria unificada LPDDR5X a unos 256 GB/s y hasta 128 GB. La capacidad permite plantear modelos grandes; no acredita una velocidad de generación con cualquier contexto. Para solo Plex y cuatro contenedores es tirar el dinero; si tu objetivo es servir modelos grandes en casa, es la caja.
Si quieres jugar en la liga de las estaciones de trabajo
ASUS Ascent GX10 — NVIDIA GB10, 128 GB
El superchip GB10 Grace Blackwell del NVIDIA DGX Spark, en una caja que sí se compra suelta. 128 GB unificados a 273 GB/s y el stack CUDA de NVIDIA: para prototipar y servir modelos que a un mini PC normal ni le caben.
- +128 GB unificados a 273 GB/s: 70B va fino y hasta 200B en FP4 le entra
- +Superchip NVIDIA GB10 con CUDA y NVIDIA DGX OS de serie
- +Interconexión ConnectX (QSFP) para enlazar dos equipos y mover modelos aún mayores; 10GbE de LAN aparte
- -Precio de estación de trabajo (~4.000 €): nicho puro
- -ARM y DGX OS: no es el servidor de contenedores de siempre
3800–4200 €
Referencia histórica
El ASUS Ascent GX10 monta el superchip NVIDIA GB10 —el mismo del DGX Spark—, con 128 GB unificados a 273 GB/s y el stack CUDA de NVIDIA de serie. El tamaño admisible depende de la cuantización y de la memoria restante para contexto y ejecución. Es nicho puro y cuesta lo que cuesta una estación de trabajo, pero si prototipas o sirves modelos que a un mini PC ni le caben, es de lo poco de esta clase que se compra suelto.
Preguntas que me hacen siempre
// preguntas frecuentes
Preguntas frecuentes
¿Necesito una gráfica dedicada cara para correr IA en local?
¿Qué es la cuantización y el 'Q4' que sale por todas partes?
¿Cuánta RAM necesito para cada tamaño de modelo?
¿Los modelos abiertos son de verdad gratis y privados?
¿Vale mi mini PC de homelab que ya tengo?
Qué haría yo
Si nunca has tocado esto, no compres nada todavía. Coge el mini PC que ya tengas, instala Ollama, baja un modelo de 8B y úsalo una semana de verdad. Vas a descubrir dos cosas: que para un montón de tareas te sobra, y dónde exactamente se te queda corto. Esa frontera, y no una gráfica de benchmarks, es la que te dice qué comprar.
Si al cabo de esa semana quieres subir de liga y meter un 70B en casa, entonces sí: la respuesta es memoria unificada de gran ancho de banda, un EVO-X2 o, si vives en Apple y te llega, un Mac de gama alta. Lo que no haría es comprar por el número de núcleos o los GB/s aislados: pediría una prueba del modelo con el contexto y la concurrencia que vaya a usar.
Actualización 6 jul 2026: instalación probada con Ollama en Linux. Los tamaños de pesos en Q4 son orientativos. La ampliación del 9 de octubre sustituye la gráfica de velocidad teórica por una cuenta reproducible de memoria KV, sin atribuir rendimiento medido.